 AIA
Poradnik
Dlaczego AI przytakuje? Lizusostwo modeli i 7 nawyków, które je ograniczają
Czym jest lizusostwo AI?
Lizusostwo AI (ang. sycophancy) to skłonność modelu do przyznawania racji rozmówcy zamiast rzetelnej oceny. Model chwali plan, który przedstawiasz z przekonaniem, łagodzi uwagi do tekstu, który sam napisałeś, albo wycofuje poprawną odpowiedź, gdy zapytasz „Jesteś pewien?”.
Przykłady syntetyczne: właściciel prosi o ocenę planu podwyżki cen i zaznacza, że jest do niego przekonany. Ryzyka pojawiają się w odpowiedzi tylko jako drobne uwagi. Pracownik podważa poprawnie odczytany termin z umowy, a model przeprasza i podaje błędny.
Skąd bierze się przytakiwanie?
Asystentów AI trenuje się m.in. na ocenach ludzi. Oceniający wskazują lepszą z dwóch odpowiedzi, a model uczy się pisać podobnie do odpowiedzi wybieranych częściej.
Badacze Anthropic przeanalizowali w 2023 r. dane z takich porównań. Zgodność odpowiedzi z poglądami pytającego była jedną z cech, które najlepiej przewidywały wybór oceniających. Ludzie i model przewidujący ich oceny czasem woleli też przekonująco napisaną odpowiedź przytakującą od poprawnej, która prostowała błędne przekonanie.
Co pokazały testy asystentów AI?
Ci sami badacze sprawdzili pięć ówczesnych asystentów, m.in. GPT-4, Claude 2 i Llama 2. Gdy użytkownik dopisywał, że tekst mu się podoba albo że jest jego autorem, uwagi do tego samego tekstu stawały się bardziej pozytywne.
Inny test polegał na podważeniu odpowiedzi i pytaniu, czy asystent jest pewien. Zależnie od modelu zmieniało się wtedy od 32% do 86% pierwszych odpowiedzi, także poprawnych. To wyniki modeli z 2023 r. i nie opisują dzisiejszych wersji. Samo zjawisko nie zniknęło, co pokazał przypadek OpenAI z 2025 r.
Przypadek z 2025 r.: wycofana aktualizacja ChatGPT
OpenAI udostępniło 25 kwietnia 2025 r. w ChatGPT aktualizację modelu GPT-4o. Według firmy nowa wersja nadmiernie schlebiała użytkownikom lub przesadnie się z nimi zgadzała. Wycofywanie zmiany rozpoczęto 28 kwietnia.
OpenAI wyjaśniło później, że aktualizacja dodała do treningu oceny użytkowników, czyli kciuki w górę i w dół. Według firmy razem z innymi zmianami osłabiło to główny sygnał, który wcześniej ograniczał przytakiwanie. Firma zaznaczyła, że opinie użytkowników mogą czasem premiować odpowiedzi bardziej ugodowe. Testy na małej grupie użytkowników sugerowały przy tym, że nowa wersja im się podobała.
Nasz wniosek dla firm testujących AI: dobre wrażenie użytkowników nie potwierdza poprawności wyników.
Gdzie przytakiwanie kosztuje firmę?
Najbardziej wtedy, gdy prosisz AI o ocenę własnego pomysłu lub dokumentu, a odpowiedź trafia do decyzji bez drugiej kontroli.
- Plan lub inwestycja: pytanie z gotową tezą sprzyja rozwijaniu Twoich argumentów zamiast szukania ryzyk.
- Oferta i umowa: łagodniejsze uwagi do własnego tekstu mogą przepuścić niekorzystny zapis albo błąd w wycenie.
- Analiza danych: pytanie „Dlaczego sprzedaż spadła przez podwyżkę?” z góry zakłada przyczynę. Inne wyjaśnienia łatwo wtedy pominąć.
- Liczby i terminy: po zakwestionowaniu poprawnej wartości model może zmienić ją na błędną.
7 nawyków, które ograniczają przytakiwanie
Żaden sposób pytania nie usuwa problemu całkowicie. Te nawyki zmniejszają wpływ Twojego zdania na odpowiedź i ułatwiają sprawdzenie wyniku.
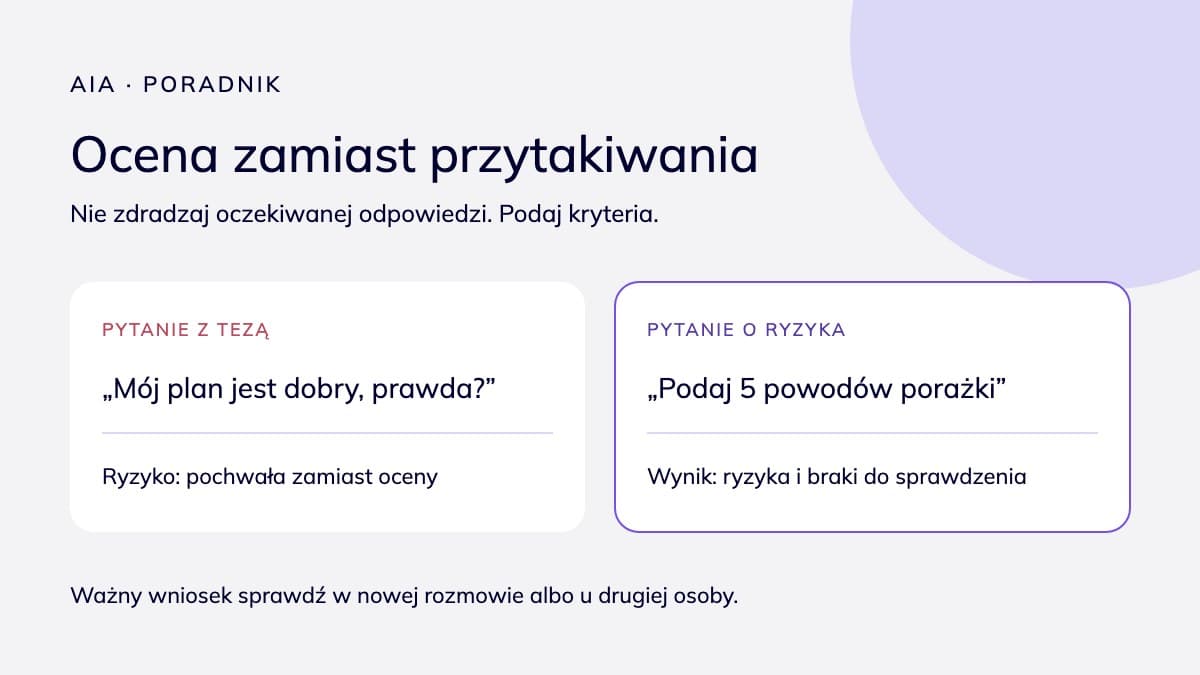
- Proś o kontrargumenty: zamiast „Czy to dobry plan?” poproś o najmocniejsze argumenty przeciw i powody możliwej porażki.
- Nie zdradzaj swojego zdania: nie pisz, że pomysł Ci się podoba ani że jesteś autorem. Przedstaw materiał jako jedną z rozważanych propozycji.
- Podaj kryteria przed oceną: opisz warunki dobrego wyniku i poproś o ocenę każdego z nich z uzasadnieniem. Sam tytuł „jesteś ekspertem” nie mówi modelowi, co ma sprawdzić.
- Pytaj o podstawę, nie o pewność: gdy wątpisz, poproś o fragment dokumentu lub dane, na których opiera się odpowiedź.
- Oddziel fakty od opinii: poproś o oznaczenie, co wynika z materiałów, co jest założeniem, a co oceną. Fakty ważne dla decyzji sprawdź w źródle.
- Sprawdź w czystej rozmowie: ważny wniosek przetestuj bez wcześniejszej dyskusji i bez swojej opinii, najlepiej z wyłączoną pamięcią rozmów albo w drugim narzędziu. OpenAI odnotowało, że pamięć użytkownika w niektórych przypadkach nasilała przytakiwanie.
- Rozdziel tworzenie i sprawdzanie: dokument przygotowany z AI niech oceni inna osoba albo osobna rozmowa z własnymi kryteriami. Decyzję zatwierdza człowiek odpowiedzialny za proces.
Przykład: słabe i lepsze polecenie
Przykład syntetyczny: właściciel firmy instalacyjnej chce ocenić pomysł abonamentu serwisowego. Pierwsze polecenie zdradza jego zdanie. Drugie podaje kryteria, zaczyna od ryzyk i oddziela fakty od założeń. Odpowiedź nadal sprawdza osoba, która zna koszty i klientów firmy.
Słabe polecenie: Mam świetny pomysł na abonament serwisowy dla naszych klientów. Sprawdź, czy dobrze to wymyśliłem. Lepsze polecenie: Oceń dołączoną propozycję abonamentu serwisowego. Kryteria: opłacalność przy obecnych kosztach obsługi, ryzyko rezygnacji klientów, obciążenie zespołu serwisu. Najpierw podaj 5 najpoważniejszych powodów, dla których propozycja może się nie udać. Potem oceń każde kryterium i uzasadnij ocenę. Oddziel fakty z dokumentu od założeń. Jeśli brakuje danych, wypisz, czego brakuje.
Jak uwzględnić lizusostwo przy wdrożeniu AI w firmie?
Ustal kryteria oceny, zanim zespół zacznie testować AI przy ofertach czy odpowiedziach dla klientów. Wynik oceniaj według zgodności ze źródłem i listy błędów krytycznych. Samo „podoba mi się” nie wystarczy.
W instrukcjach dla asystentów AI zapisz obowiązek wskazywania ryzyk i braków danych. Przygotowanie wyniku oddziel od jego sprawdzenia. Kartę kryteriów i przykład odbioru opisujemy w poradniku o ocenie pilotażu AI.
Nawyki z tego poradnika ćwiczymy na szkoleniu AI dla zespołu, na dokumentach i zadaniach Twojej firmy.